结论
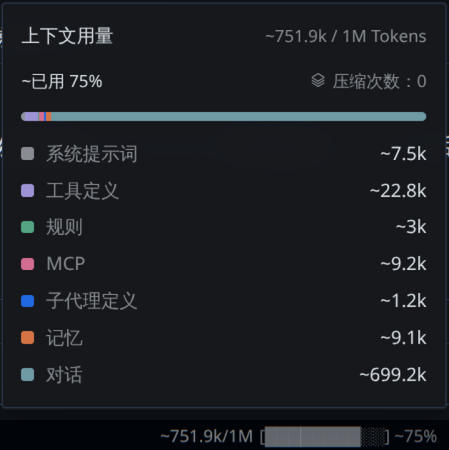
这是一个严重缺陷,不是用法问题。hermes 的上下文压缩在会话超过某个临界点后进入发散循环:每次压缩尝试都因摘要写不完而整体回滚、消息一条不删,会话继续长大,下一次更写不完。20261013_125040_a801a3(nixos v0.2.0 五项进度,deepseek-v4.1-flash,1M 窗)就是卡死在这个循环里的完整现场:576→644 条消息,66 万→89.6 万 token,自动手动各死多次,prompt 实测最高 779,970 token,离硬顶只剩约 20 万。调参(threshold 0.4)只能把临界点往后推,消灭不了它。不 new 也一定能解决:技术上就是让压缩收敛(分片、递归、预算内),不存在原理性不可能;拿 new 当答案等于把子系统的正确性义务转嫁给用户的操作习惯。
现场时间线(实测)
| 时间 | 触发 | 输入规模 | 结果 |
|---|---|---|---|
| 23:09–23:10 自动 | preflight | — | 冷却中跳过(剩余 98s / 36s) |
| 23:11 自动 | auto | messages=576,tokens≈767,372 | 41 秒后摘要截断 abort |
| 23:14 自动 | post_tool | messages=600,tokens≈789,031;middle 439K token,539 条记录进摘要 | 42 秒后同样截断 abort |
| 23:15 手动 | /compress | messages=605,tokens≈663,361;middle 434K | 41 秒后同样截断 abort |
| 23:31 手动(桌面,带主题) | /compress 聚焦主题 | focus=kvm优化和nixos继续完善细节 | 38 秒后同样截断 abort |
| 23:33 网关重启 | hermes gateway restart | 新 PID 766120,Telegram 重连正常 | 0.4 生效(日志出现 >= 400,000) |
| 23:35 手动(CLI 注入) | /compress | history=603 | preflight 因无真实用量锚点 defer;命令被当普通对话,模型陪聊回一段小结,压缩器一次没启动 |
| 23:35 后 | — | messages=644,tokens≈896,107;真实 prompt 779,970 | 继续涨,锚点已建立,下一轮会自动再试大概率再死 |
根因链(五步,每步都有判据)
1. 单遍摘要架构,没有分片。每轮压缩把整个 middle window 一次塞进一个摘要调用。遥测里 chunking:false,chunk_count:1 恒成立,代码里没有 map-reduce 或分段压 middle 的路径。middle 43 万 token 时,输入靠 lean 采样截到约 158K 字符(_SUMMARY_INPUT_MAX_CHARS=160_000),但输出侧没有对应的缩放机制。
2. 输出预算顶死 10K,撞的是提供商侧上限。摘要预算 = 内容×0.20,上限 min(上下文×0.05, 10_000),1M 模型即 10K token。调用故意不传 max_tokens(注释:硬 cap 会截断摘要),于是顶在 opencode-go 那一侧:finish_reason=length。aux 实测 prompt 71–72K token,写到顶没写完。
3. 截断被定为 terminal failure,整轮回滚。与空内容、拒答同级(_TERMINAL_SUMMARY_FAILURES):abort,消息原样保留。这是为了不让半截摘要覆盖真记忆,代价是失败不产生任何进度——605 条进去,605 条出来。
4. 失败写冷却,冷却期内自动跳过。_SUMMARY_FAILURE_COOLDOWN_SECONDS=600,实测叠加后日志里出现 700–900 秒剩余。用户看到的就是「自动上下文控制失效」。手动 /compress 走 force=True 先清冷却所以真跑了,但撞的是同一堵墙——「手动发起压缩失效」。
5. 发散:越失败越大,越大越失败。每次 abort 后新对话继续进 middle,539 条记录→更多,下一次摘要更长。这是一个不收敛的循环:压缩能力不随会话长度伸缩,存在一个过了就永久失控的临界点。本次现场临界点大约在 60 万 token / 600 条消息附近(首死于 576 条 767K)。
为什么调参救不了
| 参数 | 值 | 作用 | 结论 |
|---|---|---|---|
| threshold(本模型) | 0.4(23:30 你亲手改的,已 live) | 触发线 500K→400K,早压、每次 middle 小一点 | 推迟临界点,不消除;当前 middle 已 43 万,压完一次还是超输出顶 |
| threshold(全局) | 0.75 | 其它模型的触发线 | 与本次无关 |
| target_ratio | 名义 0.1 | lean 模式下是死旋钮(只在 legacy tail 用,且被钳在 [0.10, 0.80],0.05 写了也按 0.10 生效) | 改了等于没改,保持别碰 |
| 压缩模型 | opencode-go / deepseek-v4.1-flash,reasoning_effort none | 输出顶在这一侧 | 唯一从顶侧下手的变量是换摘要模型(输出上限更大的),需另议 |
| 底座+tail(25K+41K≈66K,占 1M 约 6–7%,且底座走缓存价) | — | 固定开销 | 合理,别动;病根在 middle,不在这 66K |
修法方向(收敛性改造,不是调参)
- 分片摘要:middle 按 token 切段分别摘要再合并(map-reduce),每片的输出独立封顶,段数随 middle 增长,总输出不再顶穿单次上限。这是根治单遍架构的正面解法。
- 递归压摘要:固定单次摘要长度上限,超了就把摘要本身再压一遍;previous summary + new turns 的迭代形式已存在,缺的是「输出超限时回退到再压一次」而不是直接 abort。
- 预算内 middle:触发时若 middle 超过「可写完」的规模,先按时间切多轮压(每轮只压最老一段),而不是一轮吃全部。0.4 是这个方向的弱版本(只提前触发,不限制单轮规模)。
- 降级路径可选:abort_on_summary_failure=false 时走静态 fallback(丢 middle 但会话能继续),现在默认 abort 是保记忆、舍继续;至少应让用户在「保记忆」和「能继续」之间有选择,而不是看起来像死机。
- 冷却期诚实上报:冷却内自动跳过时只在 debug 日志里写,用户侧显示的是上下文继续涨。应在使用量面板给出「压缩失败×N,下次重试 HH:MM」的可判定状态,而不是让用户猜。
为什么必须修,而不是 new
new 绕过的是这一次失控,不是临界点的存在。任何跨天、跨数百轮的长任务(正是这个 nixos 五项进度会话的形态)都会走到 600 条 / 60 万 token 以上——到了就死,new 只是把计时器清零重跑一遍。把「用户必须自己定期 new + 自己做交接」当成答案,等于要求用户替压缩子系统做它本该做的收敛保证,这就是侵入操作习惯。判据也很直接:修完之后,同一会话从 60 万涨到 90 万的过程中压缩应该成功至少一次且 prompt 回落到触发线附近;达不到这一点,1M 上下文的标称值对长任务就是虚的。
复核命令
# 最近几次压缩尝试(触发源/规模/成败一眼可见)
grep -n 'compression' ~/.hermes/logs/agent.log | grep '20261013_125040_a801a3' | tail -n 6

# 当前规模与失败状态
python3 -c "import sqlite3;db=sqlite3.connect('/home/cat/.hermes/state.db');print(db.execute(\\"select message_count, compression_failure_cooldown_until, compression_failure_error from sessions where id='20261013_125040_a801a3'\\").fetchone());print(db.execute(\\"select count(*), sum(length(content)) from messages where session_id='20261013_125040_a801a3'\\").fetchone())"

# 配置快照
sed -n '54,61p' ~/.hermes/config.yaml关键代码位置:agent/context_compressor.py(单遍入口 5275 force 清冷却、截断判定 3970、预算 3468/2248、冷却 600 秒见 1123、terminal 失败表见 748);遥测字段 trigger_source / middle_window_tokens / summary_input_record_count / commit_status:aborted / failure_class:summary_truncated_failure。